TL;DR
A Novita AI disponibilizou como código aberto o Chord, um operador CUDA MoE W4A16 de alto desempenho para ativações BF16, pesos INT4 e escalas de grupo 32. Construído para formas de servir Kimi K2.x, seu caminho indexado expõe a raiz de importação humming compatível com Humming, selecionada com --quantization humming em reisões compatíveis do vLLM. A integração dos operadores agrupados com o backend Humming do vLLM ainda está em andamento.
Resposta curta: O Chord é um pacote de kernls CUDA de código aberto que acelera a inferência Mixtur-of-Expets INT4 (W4A16) para Kimi K2.x em GPUs NVIDIA H200 e Blackwel. Implantações do vLLM podem usar o caminho indexado do Chord através do backend Humming existente; os operadores agrupados SM90 estão disponíveis como uma API independente enquanto a integração com o framework continua.
Medido por camada contra o caminho correspondente do Humming público:
- 1,11–1,20x no preenchimento H200 EP8, e 1,17–1,33x no H200 TP8 para servidor de instância única.
- 1,16–1,24x na decodificação H200 EP8, com o estágio down atinjindo 1,31x.
- 1,81–2,15x na decodificação B300 EP8, contra a estratégia de configuração padrão não ajustada do Humming.
- 1,00–1,31x e 1,16–1,35x para os caminhos agrupados de preenchimento e decodificação H200 EP8; as mesmas tabeas medem 1,18–1,34x no EP16 e 1,13–1,30x no EP32.

Figura 1. Latência por chamada contra o Humming público em todos os seis cenários medidos, menor é melhor. Leia cada painel individualmente: o painel de decodificação B300 compara contra um padrão não ajustado do Humming porque o Humming público não possui tabela de ajuste SM100/SM103, enquanto todo painel H200 é ajustado-para-ajustado. Gráfico do repositório Chord; tabeas completas em docs/perfomance.md.
A ideia por trás desses números é que um único kernel MoE W4A16 não pode ser adequado para toda requisição. Os tokens roteados por especialista variam em ordens de magnitude entre preenchimento e decodificação, e é essa quantidade, não o número total de tokens, que decide qual escalonamento vence. O Chord escolhe o escalonamento a partir da forma que realmente é fornecida.
Estas são medições em nível de kernel, não uma promessa do mes mo ganho de ponta a ponta para toda carga de traalho. Tabelas completas, definições de forma e metodologia de temporização estão em docs/perfomance.md e docs/benchmarking.md. O cádigo e as tabeas de kernel nese artigo referem-se a 7ca91d8 (14 de setembro de 2026).
Duas famílias de kernel
O Chord possui duas famílias de kernel MoE W4A16 INT4, cada uma ajustada para um layout de roteamento e fase de servir diferentes:
O branch main atual incui duas famílias indepndentes:
indexedé o caminho derivado do Humming. Ele consome o roteamentosorted_ids/expert_ids/num_tokens_paddeddo vLLM e cobre preenchimento H200 EP8, servidor de instância única H200 TP8, decodificação H200 EP8 e decodificação B200/B300 EP8.grouped_contiguous(preencimento) egrouped_masked(decodificação) são uma segunda famíl ia SM90 derivada do DeepGEMM. Ees consomen roteamento agrupado (m_indicesouexpert_layout) e usam um layout de pesos empacotado diferente.
Integração com vLLM
Instale o pacote e selecione o backend Humming existente:
pip install git+https://github.com/novitalabs/chord.git
# Não co-instar inclusionAI/humming: O Chord intencionalmente possui ese nome de importação (para o caminho indexado; integração agrupada está em andamento).

vllm serve <kimi-k2.x-int4-model> --quantization humming
# ou selecione moe_backend="humming" na configuração do vLLM
A distribuição fornece tanto chord quanto humming como raízes de módulo. A facada laz do vLLM resolve humming.{dtypes,config,layer,schema,utils.weight}; o caminho indexado padrão pode usar essa integração existente sem um patch de framework específico do Chord em branches com o suporte a escala de grupo WNA16 mencionado abaixo. O esquema enviado suporta uint4, grupo-32, escalas BF16 e o formato de checkpoint INT4 grupo-32 quantizado-compactado usado por Kimi K2.x; esquemas de quantização não suportados falham no carregamento em vez de selecionar silenctamente um kernel errado.
A integração agrupada com o backend Humming do vLLM está em andamento. A API do operador agrupado autônomo é mostrada abaixo.
TP8 permanece o perfil h200_tp8 indexado porque um peso TP8 deve atender ambas as fases.
Outros detalhes de implantação:
- A seção de perfil recupera EP8 versus TP8 das formas de projeção já passadas pelo framework; nenhum argumento de shard específico do Chord é necessário para os perfis indexados. Perfs agrupados são apenas EP e suportam EP8/EP16/EP32 no SM90.
- O caminho rápido indexado pode consumir os buffers superalocados
moe_align_block_sizedo vLLM sem ler a contagem roteada de volta para o host quando a validação de roteamento confiável está desativada, portanto permanece capturável por Grafo CUDA. Caminhos agrupados usam tensores de roteamento CUDA também, enquantovalid_shape_m/expected_msão entradas heurísticas do lado Python. - Selecione explicitamente Humming (
moe_backend="humming"ou--quantization humming); a prioridade automática WNA16 do vLLM pode escohler outro backend primeiro. MantehaVLLM_HUMMING_USE_F16_ACCUMeVLLM_BATCH_INVARIANTdesligados porque nenhum dos dois backends implementa essas opções de computação. - Manteha
VLLM_HUMMING_MOE_GEMM_TYPEem seu comportamento indexado para a integração padrão. Branches do vLLM antriores ao suporte genérico de escala de grupo WNA16 em #48918 podem prcisar adicionar as chaves grupo-32 a_upports_quant_scheme.
Otimizações de kernel
Kernels indexados
A famíla indexada deriva do público inclusionAI/humming commit 4351af3. Os regimes de carga de trabalho abaixo motivam diferntes perfis de kernel, selecionados antes do empacotamento dos pesos:
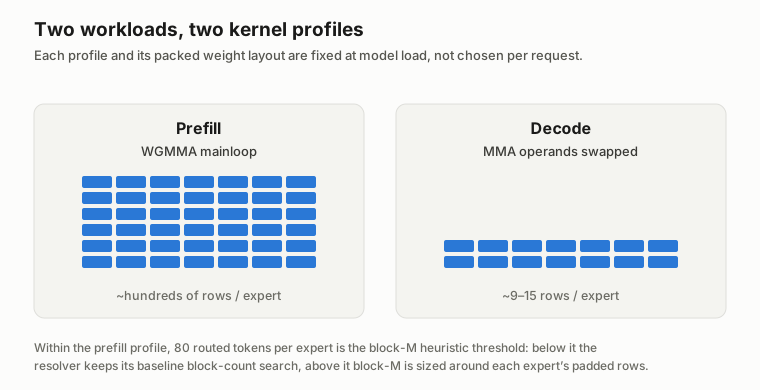
Figura 2. Cargas de traalho típicas de preenchi mento e decodificação. A etiqueta 9–15 linhas/experto ilustra um caso de teste de decodificação; 80 tokens/expert é um limiar heurístico de bloco-M de preenchimento. Nenhum defne uma chave de tde em tempo de execução entre preenchimnto e decodificação: perfis e layouts de peso são fixados no carregamento do modlo, enquanto as contagens de toens ajustam o escalonamento dento de cada perfil.
Preenchimento H200 e TP8
- Pipelining de WGMma
wait<1>em lote. Um grupo WGMma permaece em voo enquanto o próxmo carregamento e desquantização procedem, valendo cerca de 3–6% no gate/up e 1–5% no down em toda a varredura publicada. A saída é bit-idêntica; o mecanismo é descrito abaixo. - Seção de bloco-M baseada em tokens por experto. O preenchimeto indexado e a pressão de registradores são governados por tokens roteados por experto (
tok_e), não apenas pelo M roteado total. O resolvedor H200 EP8 modela essa quantidade e mante um conjunto separado e mais plano de janelas para TP8. - Uma janela limitada de 2-CTAs/SM. Para os tiles de tamanho médio onde um CTA sta limitado por latência, um limite de lançamento de 128 registradores eleva os warps residentes e oculta a reunião
cp.asyncmais a desquantização. A polí tica é aplicada apenas na janela medida bloco-M/bloco-N; fora dela a escolha original de ocupação é retida. - Controle de stream-K ciente da forma. A projeção down de K médio desativa o stream-K uma vez que a grade ordinária M×N está cheia, evitando overhead de divisão/redução. O gate/up de K profundo e os cruzamentos específicos da projeção TP8 o retêm onde ajuda.
A regra tok_e é deliberadamente simples de explicar, mas especifica para a forma MoE. Abaixo de aproximadamente 80 tokens roteados por experto, o resolvedor mantém a busca de contagem de blocos de base; acima desse ponto ele dimensiona block_m em torno das linhas preenchidas de cada experto e do teto de registradores. TP8 usa janelas mais planas porque sua dimensão intermediária estreita deixa menos tiles N para preencher um SM:
# Forma concituial da heurística de preenchimento indexado H200 EP8.
tok_e = routed_m / num_experts
if tok_e < 80:
    block_m = argmin_total_blocks(sampled_routing)
else:
    block_m = fit_padded_expert_rows(tok_e, max_block_m=176)
O mainloop WGMma também processa em lote seu gerenciamento de dependência assíncrona. Em vez de esperar por cada grupo de instruções, ele confirma após uma interação warp-K e mantém um grupo em voo enquanto o próximo carregamento de memória compartilhada e desquantização INT4 iniciam:
# Estado estacionário simplificado; prólogo e gerenciamento de estágio omitidos.
for warp_k in K_tiles:
    load_next_packed_weights_and_scales()  # memória compartilhada -> registradores
    issue_wgmma_for_iteration(warp_k)
    commit_group()
    wait_group<1>()     # um grupo pode permanecer em voo
    dequantize_next_in_alternate_buffer()  # desquant + escala de grupo
epilogue:
    wait_group<0>()
Registradores de peso duplamente bufferados permitem que o próximo carregamento e desquantização se sobreponham ao grupo WGMma pendente. O acumulador não é consumido até o epílogo, e a drenagem final ainda espera por cada operação WGMma pendente.
Decodificação indexada H200 e Blackwell
Com poucas linhas roteadas por experto, o caminho WGMMA está limitado por barreira. O perfil de decodificação troca os operandos MMA para que pesos desquantizados ocupem o operando MMA-M, usa m16n8k16 e suporta 4 CTAs/SM com bloco-M 8. Um escalonamento de tile de token semi-estático mediu 186 µs versus 216 µs para o escalonamento totalmente dinâmico em 9–15 tokens/experto. Fundir a desquantização de subtração-então-escala na extração de nibble preserva a ordem de arredondamento BF16 não fundida. A mesma família de instruções MMA é compilada para SM100/SM103; formas de decodificação Blackwell maiores usam tiles MMA não trocados mais largos. Nenhum kernel tcgen05 é necessário para essas contagens de tokens.
Kernels agrupados SM90
O backend agrupado é uma família de kernel diferente, não um segundo nome para o kernel indexado. Ele especializa a infraestrutura GEMM Hopper do DeepGEMM para W4A16 e a adapta ao JIT e lançador do Chord. Ambos os modos usam TMA, WGMMA especializado em warp e desquantização de grupo-32, mas seus layouts de roteamento e peso físico diferem:
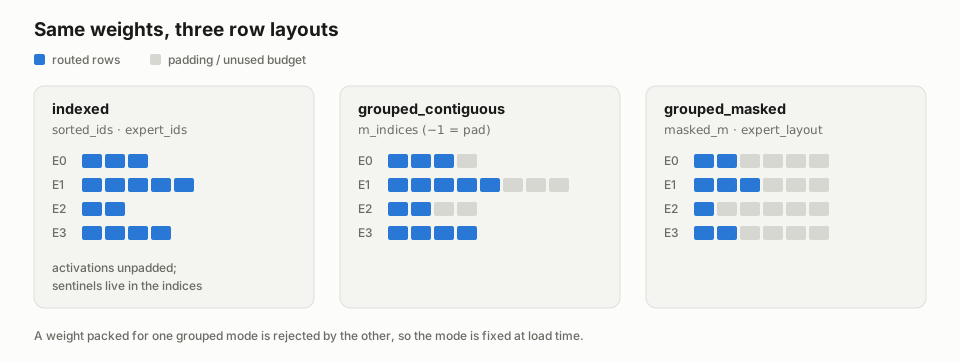
Figura 3. Onde o preenchimento vive. O indexado deixa ativações não preencidas; seus índices de roteamento carregam sentinlas de preenchimeto. O contíguo preenche cada experto até um limite de 128 linhas; o mascarado reserva um orçamento fixo de linhas por experto.
- Preenchimento contíguo: linhas são conactenadas por experto, preenchidas até limites de 128 linhas, e acompanhadas por
m_indices(int32, com-1para preechimento). Entradas são[m, K]; o empacotador usa um buffer INT4 permutado por bi comBLOCK_K=64e transpõe escalas para[G, K/32, N](N contíguo). - Decodificação mascarada: ativações têm um orçamento fixo de linhas por experto (
[G*max_m, K]ou[G, max_m, K]) emasked_m/expert_layoutcarrega a contagem válida. Seu empacotador usaBLOCK_K=128; a heurística escolheBLOCK_Ma partir de toens esperados por experto, controlaBLOCK_Npela ocupação de onda e ajusta a profundidade do estágio K bufferizado.
Pontos de entrada do operador agrupado (API do Chord apenas):
from chord_kernels import contiguos, masked
from chord_kernels.operator import pack_w4a16_grouped

# weight: códigos INT4 sem sinal [G, N, K]; scale: BF16 [G, N, K/32]
prefill_weight = pack_w4a16_grouped(weight, scale, mode="contiguous")
prefill_out = contiguos(a2, prefill_weight, m_indices)  # [m, N]

decode_weight = pack_w4a16_grouped(weight, scale, mode="masked")
decode_out = masked(a3, decode_weight, masked_m, expected_m)  # [G*max_m, N]
Aqui expected_m é um número inteiro Python positivo usado para seleção de lançamento; masked_m contém as contagens válidas autoritativas por experto. A saída mascarada é plana mesmo quando a3 é tridimensional, e os consumidores devem ignorar linhas além da contagem válida de cada experto.
O modo é registrado no peso preparado e verificado na expedição, então alimentar acidentalmente um peso empacotado de preenchimento para o kernel de decodificação falha ruidosamente. A expedição agrupada possui a busca de layout SM90 e não aceita substituições block_m ou tuning_config indexadas. A resolução do kernel e o carregamento do cubin são memorizados por descritor (e as substituições de ajuste CHORD_W4A16_*), removendo a busca repetida do lado do host medida em cerca de 30 µs em lançamentos de decodificação pequenos.
O mainloop agrupado é persistente e especializado em warp: um warpgroup produtor usa TMA para estagiar ativação, pesos empacotados e tiles de escala, enquanto warpgroups consumidores executam WGMMA e escrevem o resultado BF16. O caminho de ida vê bytes INT4 já permutados e escalas MN-major, e o descritor em cache mapeia cada forma (mode, M, N, K, expert_count) para seu cubin sem repetir a busca de layout em cada chamada de decodificação.
A heurística agrupada possui algumas escolhas que são específicas para a carga de trabalho W4A16:
- Preenchimento contíguo usa BM128/BK64 quando a grade é grande o suficiente. BM128 amortiza a desquantização INT4 e a promoção de escala sobre mais linhas, enquanto BK64 mantém cada estágio do pipeline pequeno o suficiente para deixar espaço para vários estágios na memória compartilhada. Um problema concatenado pequeno cai de volta para BM64 para que os tiles M ainda possam preencher os SMs; BM128/BK128 consumiria muita memória compartilhada e colapsaria o pipeline.
- Decodificação mascarada dimensiona BM a partir de K e da cauda roteada esperada. Um grupo mascarado pode derramar em um segundo tile M, que relê toda a dimensão K. Para gate/up de K profundo, a heurística portanto cobre aproximadamente
1.3 * expected_mlinhas para evitar essa releitura. Para down de K curto, a passada extra é mais barata, então um tileceil(1.25 * expected_m, 8)mais enxuto deixa mais espaço para estágios de pipeline. - BN mascarado está ciente de onda. BN256 mehora a amortização de dequant, mas só ajuda quando tiles N suficientes existem para manter a máquina ocupada. O resolvedor mantém BN128 para ondas subpreenchidas, incluindo o caso estreito de gate/up EP32, e mantém BN128 para BM grande em down de K curto. Gate/up de K profundo ainda pode usar BN256 quando tiles suficientes preenchem a máquina.
- A profundidade de K bufferizado é ajustada por latência em vez de maximizada. Decodificação normalmente almeja cerca de 512 elementos K bufferizados (
512 / BLOCK_Kestágios); tiles mascarados grandes almejam cerca de 768, sujeito a limites de memória compartilhada. Preencher toda a memória compartilhada disponível tornaria a reciclagem de barreira mais cara sem mehorar um lançamento de decodificação de um bloco por SM.
Essas regras são porque o agrupado não reutiliza a tabela de ajuste indexada: o backend agrupado seleciona (BM, BN, BK, cluter, stages) a partir do modo e forma reais no momento da expedição. Dentro da faixa H200 EP8 citada acima, a vantagem de preenchimento estreita em 512 linhas/experto porque ambas as implementações se aproximam do mesmo teto de taxa de transferência; as escolhas de tile e pipeline importam mais em chuncos pequenos e médios.
Medições
Quão mais rápido é o Chord do que o Humming?
As medições abaixo respondem à comparação prática diretamente: O Chord é mais rápido do que o caminho correspondente do Humming público nos cenários publicados de kernel H200 e B300, com o maor ganho listado atinjindo 2,15x na decodificação EP8 B300. Estes são resultadosp or camada, então roteamento, ativação, comunicação e outros overheads de servirão são excluídos, a menos que a tabela de ponta a ponta diga o contrário.
As tabeas de kernel usam triton.testing.do_bench e comaram cada caminho do Chord com o backend Humming público correspondente na mes ma GPU. As comparações indexadas usam a mes ma forma e sorteio de roteamento; comparações agrupadas combinam as contagens de linhas por experto. Execute os dois suites para verifiar as saídas do Chord contra uma referência PyTorch simples e imprimir suas tabeas de temporização em GPUs suportadas:
python tests/test_w4a16_indexed.py
python tests/test_w4a16_grouped.py
O resumo abaixo adiciona os tempos de chamada gate/up e down das tabeas completas. Sua aceleração é Humming (gate_up + down) / Chord (gate_up + down); exclui roteamento, ativação e comunicação.
| Cenário | Ponto de forma | Humming gate_up + down | Chord gate_up + down | Aeleração por camada |
|---|---|---|---|---|
| H200 EP8 preenchimento indexado | 2048 tokens | 701,4 µs | 587,9 µs | 1,19x |
| H200 TP8 mix indexado | 8192 tokens | 2483,4 µs | 1862,3 µs | 1,33x |
| H200 EP8 decodificação indexada | 20 tok/GPU | 413,8 µs | 333,8 µs | 1,24x |
| B300 EP8 decodificação indexada | 20 tok/GPU | 493,9 µs | 229,8 µs | 2,15x |
| H200 EP8 preenchimento agrupado | 128 linhas/experto | 1204,0 µs | 917,5 µs | 1,31x |
| H200 EP8 decodificação agrupada | 32 toens/experto | 666,3 µs | 493,4 µs | 1,35x |
A comparação B300 é intencionamente qualificada: o Huming público não possui tabela de ajuste SM100/SM103, então seu tempo padrão é uma referência não ajustada. As taxas H200 indexadas são a comparação ajustado-para-ajustado.
Ambas as famílias são medidAs contra a mes ma revisão do Humming público, 4351af3. As linhas agrupadas comparam contra os próprios caminhos grouped_contiguous/grouped_masked do Humming em vez do indexado, já que ese é o contrato que ese backend subsitui. O Humming expõe ambos como valores de GemmType despachados através de seu kernel genérico em vez de como arquivos CUDA separados, e benchmarks/bench_humming.py os seleciona com --gemm_type groupd_contiguous ou --gemm_type grouped_masked. As contagens de linhas por experto são combinadas em ambos os lados em múltiplos do limite de 128 linhas por tile — --balanced no lado do Humming e os casos alinhados em tests/test_w4a16_grouped.py — então cada linha é a mes ma forma GEMM para ambas as implementações e nenhum tile é gasto em preenchimento.
Servidor de ponta a ponta
Um relatório de servidor anterior mediu o caminho TP8 indexado no Kimi-K2.6 com 8×H200, TP8 + DCP8, cache KV FP8 e requisições ShareGPT. Amos os provedores usaram o mes mo comando --quantization humming.
| Mérica | Huming | Chord | Mudança |
|---|---|---|---|
| TTFT mádio | 2022 ms | 1849 ms | −8,6% |
| Taxa de transferência de entrada + saída de preenchimento | 20.716 tok/s | 22.712 tok/s | +9,6% |
| Taxa de transferência de saída de decodificação, lote 8 | 483 tok/s | 503 tok/s | +4,1% |
| Taxa de transferência de saída de decodificação, lote 64 | 1.650 tok/s | 1.740 tok/s | +5,5% |
| Taxa de transferência de saída de decodificação, lote 128 | 2.514 tok/s | 2.715 tok/s | +8,0% |
O preenchimento usou um token de saída com cache de prefjo desativado. A decodificação reutilizou os mes mos prompts em uma segunda passagem com um cache de prefixo complatamente aquecido. O relatório também não encontrou regressão de precisão em relação ao Humming no OCRBench e GSM8K.
Próximo passos
- Completar a integração agrupada com o backend Humming do vLLM, tornando os operadores contíguos e mascarados disponíveis através da integração existente do framework.
- Lançar kernels de preenchimento EP8 para B200/B300. Temos uma implementação funcional com desempenho promissor em testes internos e planejamos compartilhar os kernels e benchmarks em um lançamento subsequente.
Exprimente o Chord
O Chord stá disponível no GitHub: novitalabs/chord. A dcuentação cobre como começar, otimizações, desemenho, detalhes de ajuste e metodologia de benchmarc. Cmentários, problemas e relatórios de benchmark de outras implantações são muito bem-vindos.
Perguntas frequentes
O que é o Chord no vLLM?
O Chord é um pacote de kernel CUDA Mixtur-of-Expert W4A16 INT4 da Novita AI. Seu caminho indexado fornece uma raiz de importação compatível com Humming para revisões do vLLM que suportam o formato de escala de grupo WNA16 necessário.
Quais GPUs e modelos o Chord almeja?
Os perfis publicados almejam formas de servir Kimi K2.x em GPUs NVIDIA H200 e Blackwel, incluindo cenários H200 EP8/TP8 e decodificação B300 EP8. A famíla agrupada SM90 atualmente almeja GPUs da classe Hope.
O Chord está integrado ao vLLM?
O caminho indexado pode usar o backend Humming existente do vLLM com --quantization humming ou moe_backend="humming". Os operadores agrupados contíguos e mascarados são atualmente expostos através da API autônoma do Chord; a integração agrupada com o vLLM ainda stá em progresso.
Ond posso encontrar os benchmarks e instruções de configuração do Chord?
Use o repositório Chord, especialmente sua documentação como começar, desemenho e benchmarking.
Agradecimentos
O caminho indexado do Chord contrui sobre inclusionAI/Humming, enquanto o backend agrupado SM90 especializa a infratrutura GEMM Hopper do DeepGEMM para W4A16. O Chord é lançado so sob Apache-2.0. As notas de fonte do repositório registram os componentes ascendentes retidos e avisos.
Gostaríamos de agradecer à equipe Novita AI por construir e disponibilizar o Chord como código aberto, e aos mantenedores do vLLM e à comunidade vLLM mais ampla pelas discusões, revisões e a infraestrutura de backend de quantização e MoE que tornaram esta integração possível.