TL;DR
Novita AIは、Chordをオープンソース化しました。これはBF16アクティベーション、INT4重み、グループ32スケール向けの高性能W4A16 MoE CUDAオペレーターです。Kimi K2.xサービング形状向けに構築されており、そのインデックスパスはHumming互換のhummingインポートルートを公開し、互換性のあるvLLMリビジョンでは--quantization hummingで選択されます。グループ化オペレーターのvLLMのHummingバックエンドへの統合はまだ進行中です。
簡単な答え: Chordは、NVIDIA H200およびBlackwell GPU上でKimi K2.xのINT4 (W4A16) Mixture-of-Experts推論を高速化するオープンソースのCUDAカーネルパッケージです。vLLMデプロイメントは、既存のHummingバックエンドを介してChordのインデックスパスを利用できます。グループ化SM90オペレーターは、フレームワーク統合が続く間、スタンドアロンAPIとして利用可能です。
パブリックHummingの対応するパスに対するレイヤーごとの測定結果:
- H200 EP8プリフィルで1.11~1.20倍 、およびH200 TP8シングルインスタンスサービングで1.17~1.33倍。
- H200 EP8デコードで1.16~1.24倍、ダウンステージは1.31倍に達する。
- B300 EP8デコードで1.81~2.15倍(Hummingのデフォルトの未調整構成戦略との比較)。
- グループ化されたH200 EP8プリフィルおよびデコードパスで 1.00~1.31倍および1.16~1.35倍。同じテーブルではEP16で1.18~1.34倍、EP32で1.13~1.30倍。

図1. 6つの測定シナリオにおけるパブリックHummingに対する呼び出しごとのレイテンシ。低いほど良い。各パネルは独立して読んでください:B300デコードパネルは未調整のHummingデフォルトと比較しています(パブリックHummingにはSM100/SM103チューニングテーブルが付属していないため)。一方、すべてのH200パネルは調整済み同士の比較です。Chordリポジトリから引用。完全なテーブルはdocs/performance.mdを参照。
これらの数値の背後にある考え方は、単一のW4A16 MoEカーネルがすべてのリクエストに適しているわけではないということです。エキスパートあたりのルーティングトークン数はプリフィルとデコードで桁違いに異なり、どのスケジュールが最適かを決定するのは総トークン数ではなく、その量です。Chordは実際に与えられた形状からスケジュールを選択します。
これらはカーネルレベルの測定であり、すべてのワークロードで同じエンドツーエンドの利得が得られることを約束するものではありません。完全なテーブル、形状定義、タイミング手法はdocs/performance.mdおよびdocs/benchmarking.mdにあります。この記事のコードとカーネルテーブルは7ca91d8(2026年9月14日)を参照しています。
2つのカーネルファミリー
Chordには2つのW4A16 INT4 MoEカーネルファミリーがあり、それぞれ異なるルーティングレイアウトとサービングフェーズに合わせて調整されています。
現在のmainブランチは、2つの独立したファミリーを提供します:
indexedはHumming派生のパスです。vLLMのsorted_ids/expert_ids/num_tokens_paddedルーティングを使用し、H200 EP8プリフィル、H200 TP8シングルインスタンスサービング、H200 EP8デコード、B200/B300 EP8デコードをカバーします。grouped_contiguous(プリフィル)およびgrouped_masked(デコード)は、DeepGEMMから派生した2つ目のSM90ファミリーです。グループ化ルーティング(m_indicesまたはexpert_layout)を使用し、異なるパック済み重みレイアウトを採用します。
vLLM統合
パッケージをインストールし、既存のHummingバックエンドを選択します:
pip install git+https://github.com/novitalabs/chord.git
# Do not co-install inclusionAI/humming: Chord intentionally owns that import name (for indexed path, grouped integration is WIP).

vllm serve <kimi-k2.x-int4-model> --quantization humming
# or select moe_backend="humming" in the vLLM configuration
ディストリビューションはchordとhummingの両方のモジュールルートを提供します。vLLMの遅延ファサードはhumming.{dtypes,config,layer,schema,utils.weight}を解決します。デフォルトのインデックスパスは、後述のWNA16グループスケールサポートを備えたブランチでは、Chord固有のフレームワークパッチなしでこの既存の統合を利用できます。出荷されるスキーマは、uint4、グループ32、BF16スケール、およびKimi K2.xで使用されるcompressed-tensorsパック量子化INT4グループ32チェックポイント形式をサポートします。サポートされていない量子化スキームは、誤ったカーネルをサイレントに選択する代わりに、ロード時に失敗します。
vLLMのHummingバックエンドへのグループ化統合は進行中です。 スタンドアロンのグループ化オペレーターAPIは後述します。
TP8はインデックスh200_tp8プロファイルのままです。1つのTP8重みが両方のフェーズにサービスを提供する必要があるためです。
その他のデプロイメント詳細:
- プロファイル選択は、フレームワークから既に渡されたプロジェクション形状からEP8とTP8を区別します。インデックスプロファイルにはChord固有のシャード引数は必要ありません。グループ化プロファイルはEP専用であり、SM90上でEP8/EP16/EP32をサポートします。
- インデックス高速パスは、信頼できるルーティング検証が無効の場合、ルーティングカウントをホストに読み戻すことなく、vLLMの過剰割り当て
moe_align_block_sizeバッファを消費できるため、CUDA Graphキャプチャ可能なままです。グループ化パスもCUDAルーティングテンソルを使用しますが、valid_shape_m/expected_mはPython側のヒューリスティック入力です。 - Hummingを明示的に選択します(
moe_backend="humming"または--quantization humming)。vLLMの自動WNA16優先度は他のバックエンドを先に選択することがあります。VLLM_HUMMING_USE_F16_ACCUMとVLLM_BATCH_INVARIANTはオフに保ってください。どちらのバックエンドもそれらの計算オプションを実装していないためです。 VLLM_HUMMING_MOE_GEMM_TYPEはデフォルト統合のインデックス動作のままにしてください。汎用WNA16グルプスケールサポートよりも古いvLLMブランチ(#48918)では、_supports_quant_schemeにグループ32キーを追加する必要がある場合があります。
カーネル最適化
インデックスカーネル
インデックスファミリーは、パブリックinclusionAI/hummingのコミト4351af3から派生しています。以下のワークロード領域は、重みがパックされる前に選択される異なるカーネルプロファイルを動機付けます:
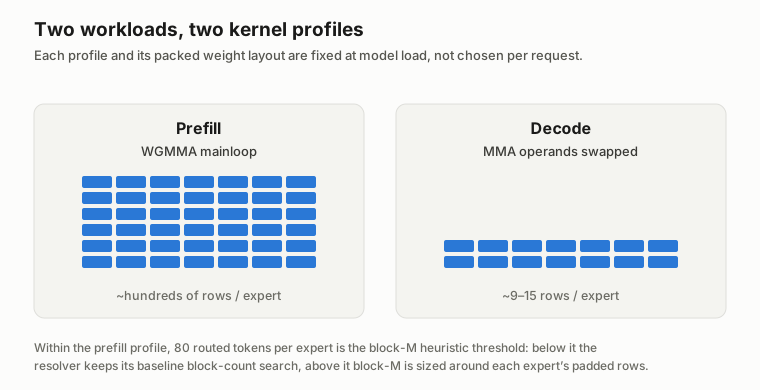
図2. 典型的なプリフィルとデコードのワークロード。9~15行/エキスパートというラベルは、デコードのテストケースを示しています。80トークン/エキスパートはプリフィルのブロックMヒューリスティック閾値です。どちらもプリフィルとデコードの間のランタイム切り替えを定義するものではありません。プロファイルと重みレイアウトはモデルロード時に固定され、トークン数が各プロファイル内のスケジュールを調整します。
H200プリフィルとTP8
- バッチ化された
wait<1>WGMMAパイプライン処理。 1つのWGMMAグループがフライト中に留まり、次のロードと量子化解除が進行します。公開されたスイープ全体で、ゲート/アップでは約3~6%、ダウンでは1~5%の効果があります。出力はビット同一です。メカニズムについては後述します。 - エキスパートあたりのトークン数によるブロックM選択。 インデックスMoEのパディングとレジスタ圧力は、ルーティングされた総Mだけでなく、エキスパートあたりのルーティングトークン数(
tok_e)によって支配されます。H200 EP8リゾルバはその量をモデル化し、TP8用に別のよりフラットなウィンドウのセットを保持します。 - 制限された2-CTAs/SMウインドウ。 1つのCTAがレイテンシバウンドとなる中サイズのタイルでは、128レジスタの起動制限キャップが常駐ワープを増やし、
cp.async集約と量子化解除を隠蔽します。このポリシーは測定されたブロックM/ブロックNウィンドウ内でのみ適用され、その外では元の占有度選択が保持されます。 - 形状認識ストリームKゲーティング。 中Kダウンプロジェクションは、通常のM×Nグリッドが満杯になるとストリームKを無効にし、分割/リダクションのオーバーヘッドを回避します。ディープKゲート/アップとTP8プロジェクション固有のクロスオーバーは、それが役立つ場所以外では保持します。
# H200 EP8インデックスプリフィルヒューリスティックの概念形。
tok_e = routed_m / num_experts
if tok_e < 80:
    block_m = argmin_totall_blocks(sampled_routing)
else:
    block_m = fit_padded_expert_rows(tok_e, max_block_m=176)
WGMMAメインループも、非同期的な依存関係管理をバッチ化します。すべての命令グループを待つ代わりに、ワープK反復後にコミットし、次のシェアードメモリロードとINT4量子化解除が開始する間、1つのグループをフライト中に保ちます:
# 簡略化された定常状態。プロローグとステージ管理は省略。
for warp_k in K_tiles:
    load_next_packed_weights_and_scales()  # shared memory -> registers
    issue_wgmma_for_iteration(warp_k)
    commit_group()
    wait_group<1>()     # one group may remain in flight
    dequantize_next_in_alternate_buffer()  # dequant + group scale
epilogue:
    wait_group<0>()
ダブルバッファリングされた重みレジスタにより、次のロードと量子化解除を未処理のWGMMAグループとオーバーラップさせることができます。アキュムレータはエピローグまで消費されず、最鉄なドレインはすべての未処理のWGMMA操作を待機します。
H200およびBlackwellインデックスデコード
エキスパートあたり数行のルーティングでは、WGMMAパスはバリアバウンドです。デコードプロファイルはMMAオペランドを交換し、量子化解除された重みがMMA-Mオペランドを占め、m16n8k16を使用し、ブロックM8で4CTAs/SMをサポートします。半静的トークンタイルスケジュールは、9~15トークン/エキスパートの完全動的スケジューラに対して186 µs対216 µsと測定されました。減算してからスケールする量子化解除をニブル抽出に融合することで、非融合BF16丸め順序を維持します。同じMMA命令ファミリーがSM100/SM103向けにコンパイルされます。より大きなBlackwellデコード形状は、より広い非交換MMAタイルを使用します。これらのトークン数にはtcgen05カーネルは必要ありません。
グループ化SM90カーネル
グループ化バックエンドは別のカーネルファミリーであり、インデックスカーネルの別名ではありません。DeepGEMMのHopper GEMMインフラをW4A16に特化し、ChordのJITとランチャーに適応させます。両モードともTMA、ワープ専用化WGMMA、グループ32量子化解除を使用しますが、ルーティングと物理的な重みレイアウトが異なります:
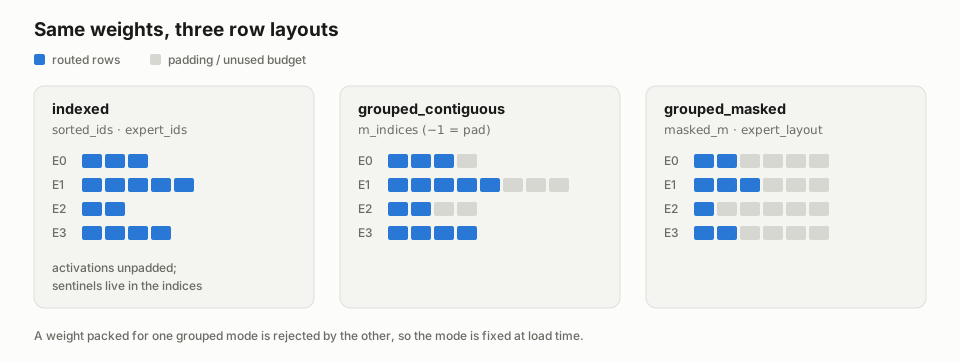
図3. パディングが存在する場所。インデックスはアクティベーションをパディングせず、ルーティングインデックスがパディングセンツイネルを運びます。連続は各エキスパートを128行境界にパディングし、マスクドはエキスパートごとに固定の行予約を確保します。
- 連続プリフィル: 行はエキスパートごとに連結され、128行境界にパディングされ、
m_indices(int32、パディングは-1)が付随します。入力は[m, K]です。パッカーはビットパーミュテーションされたINT4バッファをBLOCK_K=64で使用し、スケールを[G, K/32, N](N連続)に転置します。 - マスクドデコード: アクティベーションはエキスパートごとに固定行予算(
[G*max_m, K]または[G, max_m, K])を持ち、masked_m/expert_layoutが有効カウントを運びます。パッカーはBLOCK_K=128を使用します。ヒューリスティックは期待トークン数からBLOCK_Mを選択し、ウェーブ占有率でBLOCK_Nをゲートし、バッファリングKステージ深さを調整します。
グループ化オペレーターエントリポイント(Chord APIのみ):
from chord_kernels import contiguous, masked
from chord_kernels.operator import pack_w4a16_grouped

# weight: unsigned INT4 codes [G, N, K]; scale: BF16 [G, N, K/32]
prefill_weight = pack_w4a16_grouped(weight, scale, mode="contiguous")
prefill_out = contiguous(a2, prefill_weight, m_indices)  # [m, N]

decode_weight = pack_w4a16_grouped(weight, scale, mode="masked")
decode_out = masked(a3, decode_weight, masked_m, expected_m)  # [G*max_m, N]
ここでexpected_mは起動選択に使用される正のPython整数です。masked_mは権威あるエキスパートごとの有効カウントを保持します。マスクド出力は、a3が3次元であってもフラットであり、コンシューマーは各エキスパートの有効カウントを超える行を無視する必要があります。
モードは準備された重みに記録され、ディスパッチ時にチェックされるため、誤ってプリフィルパックされた重みをデコードカーネルに渡すと大きなエラーで失敗します。グループ化ディスパッチはSM90レイアウト検索を所有し、インデックスのblock_mやtuning_configオーバーライドを受け付けません。カーネル解決とcubinローディングはディスクリプタ(およびCHORD_W4A16_*チューニングオーバーライド)によってメモ化され、小さなデコード起動で測定された約30 µsのホスト側検索を繰り返さないようにします。
グループ化メインループは永続的でワープ専用化されています。プロデューサーワープグループはTMAを使用してアクティベーション、パック済み重み、スケールタイルをステージングし、コンシューマーワープグループはWGMMAを実行しBF16結果を書き込みます。フォワードパスは既にパーミュテーションされたINT4バイトとMNメジャースケールを参照し、キャッシュされたディスクリプタは各(mode, M, N, K, expert_count)形状を、デコード呼び出しごとにレイアウト検索を繰り返すことなくそのcubinにマッピングします。
グループ化ヒューリスティックには、W4A16ワークロードに固有のいくつかの選択があります:
- 連続プリフィルは、グリッドが十分大きい場合、BM128/BK64を使用します。 BM128はINT4量子化解除とスケールプロモーションをより多くの行に分散し、BK64は各パイプラインステージを十分小さく保ち、共有メモリに複数のステージの余地を残します。小さな連結問題はBM64にフォールバックし、MタイルがSMを埋められるようにします。BM128/BK128では共有メモリを消費しすぎてパイプラインが崩壊します。
- マスクドデコードは、Kと期待されるルーティング末尾からBMをサイジングします。 マスクドグループは2番目のMタイルに溢れる可能性があり、その場合K次元全体を再読み取りします。したがって、ディープKゲート/アップでは、ヒューリスティックは約
1.3 * expected_m行をカバーしてその再読み取りを回避します。ショートKダウンの場合、追加パスはより安価であるため、よりスリムなceil(1.25 * expected_m, 8)タイルはパイプラインステージのための余地を残します。 - マスクドBNはウェーブ認識です。 BN256は量子化解除の償却を改善しますが、マシンをビジーに保つのに十分なNタイルが存在する場合にのみ役立ちます。リゾルバは、狭いEP32ゲート/アップケースを含むアンダーフィルドウェーブにはBN128を保持し、ショートKダウンの大きなBMにもBN128を保持します。ディープKゲート/アップは、十分なタイルがマシンを埋める場合にはBN256を使用できます。
- バッファリングK深さは最大化ではなくレイテンシチューニングされます。 デコードは通常、約512のバッファリングK要素(
512 / BLOCK_Kステージ)を目標とします。大きなマスクドタイルは、共有メモリ制限に従い約768を目標とします。利用可能なすべての共有メモリを満たすと、1ブロック/SMのデコード起動を改善することなくバリアのリサイクルがより高くつきます。
これらのルールが、グループ化がインデックスチューニングテーブルを再利用しない理由です。グループ化バックエンドは、ディスパッチ時に実際のモードと形状から( BM, BN, BK, cluster, stages )を選択します。上記のH200 EP8範囲内では、512行/エキスパートでプリフィルのアドバンテージは狭まります。両方の実装が同じスループット上限に近づくためです。タイルとパイプラインの選択は、小さなチャンクと中程度のチャンクで最も重要です。
測定
ChordはHummingよりどれくらい高速ですか?
以下の測定は、実際の比較に直接答えます。Chordは、公開されたH200およびB300のカーネルレベルのシナリオにおいて、対応するパブリックHummingパスよりも高速であり、最大でB300 EP8デコードで2.15倍の利得を達成しています。これらはレイヤーごとの結果であるため、ルーティング、アクティベーシン、通信、その他のサービングオーバーヘッドは、エンドツーエンドのテーブルで別途記載がない限り除外されています。
カーネルテーブルはtriton.testing.do_benchを使用し、各Chordパスを同じGPU上の対応するパブリックHummingバックエンドと比較します。インデックス比較は同じ形状とルーティングドローを使用し、グループ化比較はエキスパートあたりの行数を一致させます以。以下の2つのスイートを実行して、Chordの出力をプレインPyトーチ参照に対して確認し、サポートされているGPUでタイミングテーブルを印刷します:
python tests/test_w4a16_indexed.py
Python tests/test_w4a16_grouped.py
以下のサマリは、完全なテーブルからゲート/アップおよびダウン呼び出し時間を加算したものです。スピードアップはHumming (gate_up + down) / Chord (gate_up + down)であり、ルーティング、アクテイベーション、通信は除外されています。
| Scenario | Shape point | Humming gate_up + down | Chord gate_up + down | Layer speedup |
|---|---|---|---|---|
| H200 EP8 indexed prefill | 2048 tokens | 701.4 µs | 587.9 µs | 1.19x |
| H200 TP8 indexed mix | 8192 tokens | 2483.4 µs | 1862.3 µs | 1.33x |
| H200 EP8 indexed decode | 20 tok/GPU | 413.8 µs | 333.8 µs | 1.24x |
| B300 EP8 indexed decode | !20 tok/GPU | 493.9 µs | 229.8 µs | 2.15x |
| H200 EP8 grouped prefill | 128 rows/expert | 1204.0 µs | 917.5 µs | 1.31x |
| H200 EP8 grouped decode | 32 tokens/expert | 666.3 µs | 493.4 µs | 1.35x |
B300の比較は意図的に限定されています。パブリックHummingにはSM100/SM103のチューニングテーブルがないため、そのデフォルト時間は未調整のリファレンスです。H200のインデックス比率は調整済み同士の比較です。
両方のファミリーは、同じパブリックHummingリビジョン4351af3に対して測定されています。グループ化行は、Hummingのインデックスパスではなく、Humming自身のgrouped_contiguous/grouped_maskedパスと比較しています。これがこのバックエンドが置き換える契約だからです。Hummingは両方を、別々のCUDAファイルとしてではなく、GemmType値として公開し、汎用カーネルを介してディスパッチします。benchmarks/bench_humming.pyは--gemm_type grouped_contiguousまたは--gemm_type grouped_maskedでそれらを選択します。エキスパートあたりの行数は、両側で128行タイル境界の倍数で一致させています。Humming側では--balanced、tests/test_w4a16_grouped.py内の整列ケースで一致させています。したがって、各行は両方の実装で同じGEMM形状であり、パディングにタイルが費やされることはありません。
エンドツーエンドサービング
以前のサービングレポートでは、Kimi-K2.6上のインデックスTP8パスを8×H200、TP8 + DCP8、FP8 KVキャッシュ、ShareGPTリクエストで測定しました。両方のプロバイダーは同じ--quantization hummingコマンドを使用しました。
| Metric | Humming | Chord | Change |
|---|---|---|---|
| Mean TTFT | 2022 ms | 1849 ms | −8.6% |
| Prefill input + output throughput | 20,716 tok/s | 22,712 tok/s | +9.6% |
| Decode output throughput, batch 8 | 483 tok/s | 503 tok/s | +4.1% |
| Decode output throughput, batch 64 | 1650 tok/s | 1740 tok/s | +5.5% |
| Decode output throughput, batch 128 | 2514 tok/s | 2715 tok/s | +8.0% |
プリフィルは1つの出力トークンを使用し、プレフィックスキャッシュは無効にしました。デコードは、完全にウォームなプレフィックスキヤッシュを使用して、2回目のパスで同じプロンプトを再利用しました。レポートでは、OCRBenchとGSM8KにおいてHummingと比較して精度の低下は見られませんでした。
今後の予定
- vLLMのHummingバックエンドとのグループ化統合を完了し、連続およびマスクドオペレーターを既存のフレームワーク統合を通じて利用可能にします。
- B200/B300向けのEP8プリフィルカーネルをリリースします。 内部テストで有望なパフォーマンスを示す動作する実装があり、今後のリリースでカーネルとベンチマークを共有する予定です。
Chordを試す
ChordはGitHubで入手できます:novitalabs/chord。ドキュメントははじめ方、最適化、パフォーマンス、チューニング内部、ベンチマーク手法をカバーしています。フィードバック、問題報告、他のデプロイメントからのベンチマークレポートを歓迎します。
よくある質問
vLLMにおけるChordとは何ですか?
Chordは、Novita AIによるW4A16 INT4 Mixture-of-Experts CUDAカーネルパッケージです。そのインデックスパスは、必要なWNA16グループスケール形式をサポートするvLLMリビジョン向けに、Humming互換のインポートルートを提供します。
ChordはどのGPUとモデルを対象としていますか?
公開されているプロファイルは、NVIDIA H200およびBlackwell GPU上のKimi K2.xサービング形状を対象としており、H200 EP8/TP8およびB300 EP8デコードシナリオを含みます。グループ化SM90ファミリーは現在、HopperクラスのGPUを対象としています。
ChordはvLLMと統合されていますか?
インデックスパスは、--quantization hummingまたはmoe_backend="humming"でvLLMの既存のHummingバックエンドを使用できます。グループ化連続およびマスクドオペレーターは現在、スタンドアロンのChord APIを通じて公開されています。vLLMとのグループ化統合はまだ進行中です。
Chordのベンチマークと設定手順はどこにありますか?
Chordリポジトリ、特にはじめ方、パフォーマンス、ベンチマーキングのドキュメントを参照してください。
謝辞
ChordのインデックスパスはinclusionAI/Humming上に構築されており、グループ化SM90バックエンドはDeepGEMMのHoper GEMMインフラストラクチュアをW4A16に特化させています。ChordはApache-2.0の下でリリースされています。リポジトリのソースノートには、保持されているアップストリームコンポーネントと通知が記録されています。
Chordを構築しオープンソース化してくれたNovita AIチーム、そしてこの統合を可能にした議論、レビュー、量子化とMoEバックエンドインフラストラクチャを提供してくれたvLLMメンテナとvLLMコミュニティの皆様に感謝します。