TL;DR
Novita AI hat Chord als Open Source veröffentlicht – einen leistungsstarken W4A16-MoE-CUDA-Operator für BF16-Aktivierungen, INT4-Gewichte und Group-32-Skalierungen. Entwickelt für Kimi-K2.x-Serving-Shapes, stellt der indexierte Pfad das Humming-kompatible Import-Root humming bereit, das mit --quantization humming auf kompatiblen vLLM-Revisionen ausgewählt wird. Die Integration der gruppierten Operatoren mit dem Humming-Backend von vLLM ist noch in Arbeit.
Kurze Antwort: Chord ist ein Open-Source-CUDA-Kernelpaket, das die INT4 (W4A16) Mixture-of-Experts-Inferenz für Kimi K2.x auf NVIDIA H200- und Blackwell-GPUs beschleunigt. vLLM-Bereitstellungen können den indizierten Pfad von Chord über das bestehende Humming-Backend nutzen; die gruppierten SM90-Operatoren stehen als eigenständige API zur Verfügung, während die Framework-Integration fortgesetzt wird.
Gemessen pro Layer gegen den passenden Pfad von öffentlichem Humming:
- 1,11–1,20x auf H200 EP8 Prefill und 1,17–1,33x auf H200 TP8 Single-Instance-Serving.
- 1,16–1,24x auf H200 EP8 Decode, wobei die Down-Stufe 1,31x erreicht.
- 1,81–2,15x auf B300 EP8 Decode gegenüber dem untuned-Standard von Humming.
- 1,00–1,31x und 1,16–1,35x für die gruppierten H200-EP8-Prefill- und Decode-Pfade; dieselben Tabellen messen 1,18–1,34x auf EP16 und 1,13–1,30x auf EP32.

Abbildung 1. Latenz pro Aufruf gegenüber öffentlichem Humming in den sechs gemessenen Szenarien, niedriger ist besser. Jedes Panel ist für sich zu betrachten: Das B300-Docode-Panel vergleicht mit einem untuned-Humming-Standard, da öffentliches Humming keine SM100/SM103-Tuning-Tabelle ausliefert, während jedes H200-Panel tuned-to-tuned ist. Diagramm aus dem Chord-Repository; vollständige Tabellen in docs/performance.md.
Die Idee hinter diesen Zahlen ist, dass ein einzelner W4A16-MoE-Kernel nicht für jede Anfrage richtig sein kann. Die Anzahl der gerouteten Token pro Experte variiert um Größenordnungen zwischen Prefill und Decode, und diese Größe – nicht die Gesamtzahl der Token – entscheidet, welcher Schedule gewinnt. Chord wählt den Schedule basierend auf der tatsächlich erhaltenen Form.
Dies sind Kernel-Level-Messungen, keine Garantie für denselben End-to-End-Gewinn für jede Workload. Vollständige Tabellen, Formdefinitionen und Methodik zur Zeitmessung finden Sie in docs/performance.md und docs/benchmarking.md. Code und Kernel-Tabellen in diesem Beitrag beziehen sich auf 7ca91d8 (14. September 2026).
Zwei Kernel-Familien
Chord hat zwei W4A16 INT4 MoE Kernel-Familien, jede optimiert für ein anderes Routing-Layout und eine andere Serving-Phase:
Der aktuelle main-Branch liefert zwei unabhängige Familien:
indexedist der von Humming abgeleitete Pfad. Er nutztsorted_ids/expert_ids/num_tokens_paddedRouting von vLLM und deckt H200 EP8 Prefill, H200 TP8 Single-Instance-Serving, H200 EP8 Decode und B200/B300 EP8 Decode ab.grouped_contiguous(Prefill) undgrouped_masked(Decode) sind eine zweite SM90-Familie, die von DeepGEMM abgeleitet ist. Sie nutzen gruppiertes Routing (m_indicesoderexpert_layout) und ein anderes gepacktes Gewichtslayout.
vLLM-Integration
Installieren Sie das Paket und wählen Sie das bestehende Humming-Backend aus:
pip install git+https://github.com/novitalabs/chord.git
# Ko-Installation von inclusionAI/humming vermeiden: Chord besitzt diesen Importnamen bewusst (für den indizierten Pfad; die gruppierte Integration ist in Arbeit).

vllm serve <kimi-k2.x-int4-model> --quantization humming
# oder wählen Sie moe_backend="humming" in der vLLM-Konfiguration
Die Distribution stellt sowohl chord - als auch humming -Modul-Roots zur Verfügung. Das Lazy-Facade von vLLM löst humming.{dtypes,config,layer,schema,utils.weight} auf; der standardmäßige indizierte Pfad kann diese bestehende Integration ohne einen Chord-spezifischen Framework-Patch auf Branches mit der unten erwähnten WNA16-Group-Scale-Unterstützung nutzen. Das mitgelieferte Schema unterstützt uint4, group-32, BF16-Skalierungen und das compressed-tensors pack-quantized INT4 group-32 Checkpoint-Format, das von Kimi K2.x verwendet wird; nicht unterstützte Quantisierungsschemata schlagen beim Laden fehl, anstatt stillschweigend einen falschen Kernel auszuwählen.
Die Integration der gruppierten Operatoren mit dem Humming-Backend von vLLM ist in Arbeit. Die eigenständige gruppierte Operator-API wird unten gezeigt.
TP8 bleibt das indexierte h200_tp8 Profil, da ein TP8-Gewicht beiden Phasen dienen muss.
Weitere Bereitstellungsdetails:
- Die Profilauswahl erkennt EP8 gegenüber TP8 anhand der Projektions-Shapes, die bereits vom Framework übergeben werden; für die indizierten Profile ist kein Chord-spezifisches Shard-Argument erforderlich. Gruppierte Profile sind reine EP-Profile und unterstützen EP8/EP16/EP32 auf SM90.
- Der indexierte Fast Path kann die überzähligen
moe_align_block_size-Puffer von vLLM konsumieren, ohne die geroutete Anzahl zurück zum Host zu lesen, wenn die vertrauenswürdige Routing-Validierung deaktiviert ist, sodass er CUDA-Graph-fähig bleibt. Gruppierte Pfade verwenden ebenfalls CUDA-Routing-Tensoren, währendvalid_shape_m/expected_mPython-seitige Heuristik-Eingaben sind. - Wählen Sie explizit Humming aus (
moe_backend="humming"oder--quantization humming); die automatische WNA16-Priorität von vLLM könnte zuerst ein anderes Backend wählen. Halten SieVLLM_HUMMING_USE_F16_ACCUMundVLLM_BATCH_INVARIANTdeaktiviert, da keines der beiden Backends diese Berechnungsoptionen implementiert. - Lassen Sie
VLLM_HUMMING_MOE_GEMM_TYPEfür die Standardintegration auf seinem indizierten Verhalten. vLLM-Branches, die älter sind als die generische WNA16-Group-Scale-Unterstützung in #48918, benötigen möglicherweise das Hinzufügen der Group-32-Schlüssel zu_supports_quant_scheme.
Kernel-Optimierungen
Indizierte Kernel
Die indizierte Familie leitet sich vom öffentlichen inclusionAI/humming Commit 4351af3 ab. Die untenstehenden Workload-Regime motivieren unterschiedliche Kernel-Profile, die ausgewählt werden, bevor Gewichte gepackt werden:
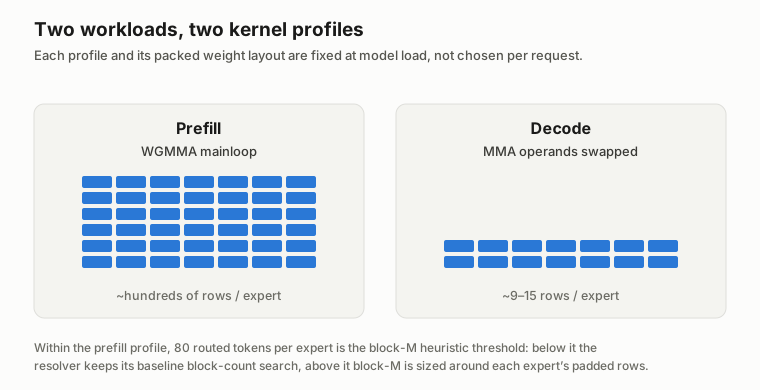
Abbildung 2. Typische Prefill- und Decode-Workloads. Die Beschriftung 9–15 Zeilen/Experte veranschaulicht einen Decode-Testfall; 80 Token/Experte ist ein Prefill-Block-M-Heuristik-Schwellenwert. Keiner definiert einen Laufzeit-Umschalter zwischen Prefill und Decode: Profile und Gewichtslayouts werden beim Modell-Laden festgelegt, während Tokenanzahlen den Schedule innerhalb jedes Profils optimieren.
H200 Prefill und TP8
- Batched
wait<1>WGMMA Pipelining. Eine WGMMA-Gruppe bleibt in Flight, während das nächste Laden und die Dequantisierung ablaufen, was etwa 3–6% bei Gate/Up und 1–5% bei Down über den veröffentlichten Sweep einbringt. Die Ausgabe ist bitidentisch; der Mechanismus wird unten beschrieben. - Tokens-per-Expert Block-M Auswahl. Das indizierte MoE-Padding und der Registerdruck werden durch die gerouteten Token pro Experte (
tok_e) bestimmt, nicht nur durch das gesamte geroutete M. Der H200-EP8-Resolver modelliert diese Größe und hält einen separaten, flacheren Satz von Fenstern für TP8. - Ein begrenztes 2-CTAs/SM-Fenster. Für mittelgroße Tiles, bei denen ein CTA latenzgebunden ist, erhöht eine 128-Register-Launch-Bound-Cap die residenten Warps und versteckt
cp.asyncGather plus Dequantisierung. Die Richtlinie wird nur im gemessenen Block-M/Block-N-Fenster angewendet; außerhalb wird die ursprüngliche Occupancy-Wahl beibehalten. - Shape-bewusstes Stream-K-Gating. Die mittlere K-Down-Projektion deaktiviert Stream-K, sobald das normale M×N-Grid voll ist, um Split/Reduction-Overhead zu vermeiden. Deep-K Gate/Up und die TP8-Projektion-spezifischen Crossovers behalten es dort, wo es hilft.
Die tok_e-Regel ist bewusst einfach erklärbar, aber spezifisch für die MoE-Form. Unterhalb von etwa 80 gerouteten Token pro Experte behält der Resolver die Baseline-Block-Count-Suche; oberhalb dieses Punktes dimensioniert er block_m um die gepaddeten Zeilen jedes Experten und die Registerobergrenze. TP8 verwendet flachere Fenster, da seine schmale Zwischendimension weniger N-Tiles hinterlässt, um einen SM zu füllen:
# Konzeptuelle Form der H200-EP8-indexierten-Prefill-Heuristik.
tok_e = routed_m / num_experts
if tok_e < 80:
    block_m = argmin_total_blocks(sampled_routing)
else:
    block_m = fit_padded_expert_rows(tok_e, max_block_m=176)
Die WGMMA-Mainloop batched auch ihr asynchrones Abhängigkeitsmanagement. Anstatt auf jede Anweisungsgruppe zu warten, commitet sie nach einer Warp-K-Iteration und hält eine Gruppe in Flight, während das nächste Shared-Memory-Load und die INT4-Dequantisierung starten:
# Vereinfachter Steady State; Prolog und Stage-Management weggelassen.
for warp_k in K_tiles:
    load_next_packed_weights_and_scales()  # shared memory -> registers
    issue_wgmma_for_iteration(warp_k)
    commit_group()
    wait_group<1>()     # eine Gruppe kann in Flight bleiben
    dequantize_next_in_alternate_buffer()  # dequant + group scale
epilogue:
    wait_group<0>()
Doppelt gepufferte Gewichtsregister lassen das nächste Laden und Dequantisieren mit der ausstehenden WGMMA-Gruppe überlappen. Der Akkumulator wird erst im Epiloog verbraucht, und der finale Draiin wartet dennoch auf jede ausstehende WGMMA-Operaation.
H200 und Blackwell indexieter Decode
Bei wenigen gerouteten Zeilen pro Expert ist der WGMMA-Pfad Barir-gebunden. Das Decode-Profil tauscht die MMA-Operanden, sodass dequantisierte Gewichte den MMA-M-Oprand belegen, verwendet m16n8k16 und untertützt 4 CTAs/SM mit Block-M 8. Ein semi-statischer Token-Tile-Schedule maß 186 µs gegenüber 216 µs für den volldynamischen Schedule bei 9–15 Token/Expert. Das Verchmelzen von Subtrakt-dann-Skalieren-Dequantisierung in die Nibbel-Extraktion bewahrt die unverschmolzene BF16-Rundungsreihenfolge. Die selbe MMA-Instruktionsfamilie wird für SM100/SM103 kompiliert; größere Blackwell-Decode-Shapes verwendet breitere nicht-vertauschte MMA-Tiles. Für diese Tokenzahlen ist kein tcgen05-Kernel erforderlich.
Gruppierte SM90-Kernel
Das gruppierte Backend ist eine andere Kernel-Familie, nicht ein zweiter Name für den indizierten Kernel. Es spezialisiert die DeepGEMM-Hopper-GEMM-Infrastruktur für W4A16 und passt sie an den JIT und Launcher von Chord an. Beide Modi verwenden TMA, Warp-spezialisierte WGMMA und Group-32-Dequantisierung, aber ihr Routing und ihre physischen Gewichtslayouts unterscheiden sich:
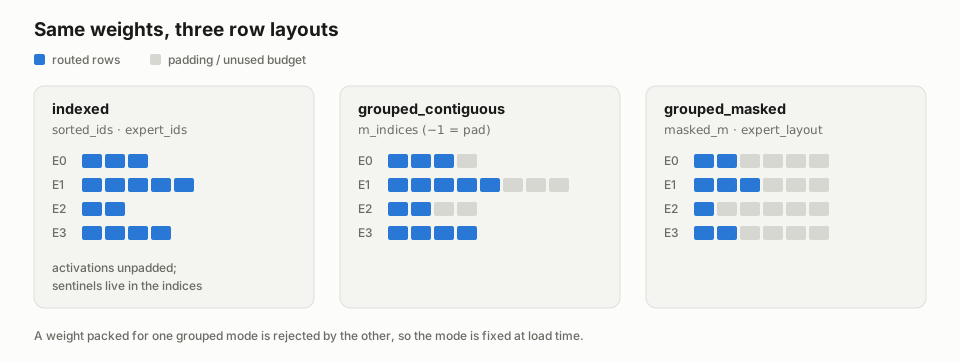
Abbildung 3. Wo Padding lebt. Indiziert lässt Aktivierungen ungepadet; seine Routing-Indizes tragen Padding-Sentinel. Kontiguös padet jeden Experten auf eine 128-Zeilengrenze; maskiert reserviert ein festes Zeilenbudget pro Experten.
- Kontiguöser Prefill: Zeilen werden nach Experte konkateniert, auf 128-Zeilengrenzen gepadet und von
m_indices(int32, mit-1für Padding) begleitet. Eingaben sind[ m, K]; der Packer verwendet einen bit-permutierten INT4-Puffer mitBLOCK_K=64und transponiert Skalierungen nach[G, K/32, N](N kontiguös). - Maskierter Decode: Akivationen haben ein festes Zeilenbudget pro Experten (
[G* max_m, K]oder[G, max_m, K]) undmasked_m/expert_layoutträgt die gültige Anzahl. Sein Packer verwendetBLOCK_K=128; die Heuristik wähltBLOCK_Maus erwarteten Token pro Experten, steuertBLOCK_Ndurc Wave-Occupancy und stimmt die geufferte-K-Stufentiefe ab.
Gruppierte Operatoreintrittspunkte (nur Chord API):
from chord_kernels import contiguous, masked
from chord_kernels.operator import pack_w4a16_grouped

# weight: unsigned INT4 codes [G, N, K]; scale: BF16 [G, N, K/32]
prefill_weight = pack_w4a16_grouped(weight, scale, mode="contiguous")
prefill_out = contiguous(a2, prefill_weight, m_indices) # [m, N]

decode_weight = pack_w4a16_grouped(weight, scale, mode="masked")
decode_out = masked(a3, decode_weight, masked_m, expected_m)  # [G*max_m, N]
Hier ist expected_m eine positive Python-Ganzzahl, die für die Launch-Auswahl verwendet wird; masked_m enthält die autoritativen gültigen Zähler pro Experten. Die maskierte Ausgabe ist flach, auch wenn a3 dreidimensional ist, und Verbraucher müssen Zeilen jenseits der gültigen Anzahl jedes Experten ignorieren.
Der Modus wird im vorbereiteten Gewicht verzeichnet und beim Dispatch überprüft, sodass das versehentliche Füttern eines Prefill-gepackten Gewichts in den Decode-Kernel laut scheitert. Der gruppierte Dispatch besitzt die SM90-Layout-Suche und akzeptiert keine indizierten block_m- oder tuning_config-Überschreibungen. Die Kernel-Auflösung und das Laden von Cubins werden durch Deskriptor (und die CHORD_W4A16_*-Tuning-Überschreibungen) memoized, wodurch die wiederholte Host-seitige Suche entfällt, die bei kleinen Decode-Starts mit etwa 30 µs gemessen wurde.
Die gruppierte Mainloop ist persistent und Warp-spezialisiert: Eine Producer-Warpgroup verwendet TMA, um Aktivierungs-, Packgewichts- und Skalierungsstiles zu stage, während Consumer-Warpgroups WGMMA ausführen und das BF16-Ergebnis schreiben. Der Vorwärtspfad sieht bereits permutierte INT4-Bytes und MN-Hauptskalierungen; der gecachte Deskriptor bildet jeden (mode, M, N, K, expert_count)-Shape auf sein Cubin ab, ohne die Layout-Suche bei jedem Decode-Aufruf zu wiederholen.
Die gruppierte Heuristik hat einige Wahlen, die spezifisch für die W4A16-Workload sind:
- Kontinuierlicher Prefill verwendet BM128/BK64, wenn das Grid groß genug ist. BM128 amortisiert INT4-Dequantisierung und Skalenpromotion über mehr Zeilen, während BK64 jede Pipeline-Stufe klein genug hält, um Platz für mehrere Stufen im Shared Memory zu lassen. Ein kleines konkateniertes Problem fällt auf BM64 zurück, damit die M-Tiles die SMs noch füllen können; BM128/BK128 würden zu viel Shared Memory verbrauchen und die Pipeline zusammenbrechen lassen.
- Maskierter Decode dimensioniert BM aus K und dem erwarteten gerouteten Tail. Eine maskierte Gruppe kann in ein zweites M-Tile überlaufen, das die gesamte K-Dimension erneut liest. Für Deep-K Gate/Up deckt die Heuristik daher etwa
1.3 * expected_mZeilen ab, um dieses erneute Lesen zu vermeiden. Für Kurz-K Down ist der zusätzliche Durchgang billiger, also lässt ein schlankeresceil(1.25 * expected_m, 8)-Tile mehr Platz für Pipeline-Stufen. - Masked BN ist wellenbewusst. BN256 verbessert die Dequant-Amortisierung, hilft aber nur, wenn genügend N-Tiles existieren, um die Maschine ausgelastet zu halten. Der Resolver behält BN128 für unterfüllte Wellen, einschließlich des schmalen EP32 Gate/Up-Falls, und behält BN128 für große BM bei Kurz-K Down. Deep-K Gate/Up kann dennoch BN256 verwenden, wenn genügend Tiles die Maschine füllen.
- Die geufferte-K-Tiefe ist latenzgetunt statt maximiert. Decode zielt normalerweise auf etwa 512 geufferte K-Elemente (
512 / BLOCK_KStufen) ab; große maskierte Tiles zielen auf etw 768, vorbehaltlich Shared-Memory-Grenzen. Das Füllen des gesamten verfühgbaren Shared Memory würde das Barrier-Recyceln teurer machen, ohne einen Ein-Block-pro-SM-Decode-Start zu verbessern.
Diese Regeln sind der Grund, warum grouped nicht die indexierte Tuning-Tabelle wiederverwendet: Das gruppierte Backend wählt ( BM, B N, B K, clster, stages) aus dem tatsächlichen Modus und Shape zum Zeitpunkt des Dispatch aus. Innerhalb des obigen H200 EP8-Bereichs verringert sich der Prefill-Vorteil bei 512 Zeilen/Expert, da beide Implementierungen sich der gleichen Durchsatzgrenze nähern; die Tile- und Pipeline-Wahl ist bei kleinen und mittleren Blöcken am wichtigsten.
Messungen
Wie viel schneller ist Chord als Humming?
Die untenstehenden Messungen beantworten den praktischen Vergleich direkt: Chord ist schneller als der passende öffentliche Humming-Pfad in den veröffentlichten H200- und B300-Kernel-Level-Szenarien, wobei der größte gelistete Gewinn 2,15x auf B300 EP8 Decode errecht. Dies sind Ergebnisse pro Layer, sodass Routing, Aktivierung, Kommunikation und andere Serving-Overheads ausgeschlossen sind, es sei denn die End-to-End-Tabelle sagt anderes.
Die Kernel-Tabellen verwenden triton.testing.do_bench und vergleichen jeden Chord-Pfad mit dem passenden öffentlichen Humming-Backend auf der selben GPU. Indexierte Verleiche verwenden denselben Shape und dassselbe Routing-Draw; gruppierte Vergleiche stimmen die Zeilen pro Expert überein. Füren Sie die beiden Suiten aus, um die Ausgaben von Chord gegen eine Plain-PyTorch-Referenz zu prüfen und die Zeitmessungstabellen auf unterstützen GPUs auszugeben:
python tests/test_w4a16_indexed.py
python tests/test_w4a16_grouped.py
Die Zusammenfassung unten addiert die Gate/Up- und Down-Aufrufzeiten aus den vollen Tabellen. Ihr Speedup istt Humming (gate_up + down) / Chord (gate_up + down); es schließt Routing, Aktivierung und Kommunikation aus.
| Szenario | Shape Punkt | Humming gate_up + down | Chord gate_up + down | Layer Speedup |
|---|---|---|---|---|
| H200 EP8 indexiert Prefill | 2048 Token | 701.4 µs | 587.9 µs | 1.19x |
| H200 TP8 indexiert Mix | 8192 Token | 2483.4 µs | 1862.3 µs | 1.33x |
| H200 EP8 indexiert Decode | 20 tok/GPU | 413.8 µs | 333.8 µs | 1.24x |
| B300 EP8 indexiert Decode | 20 tok/GPU | 493.9 µs | 229.8 µs | 2.15x |
| H200 EP8 gruppiert Prefill | 128 rows/expert | 1204.0 µs | 917.5 µs | 1.31x |
| H200 EP8 gruppiert Decode | 32 tokens/expert | 666.3 µs | 493.4 µs | 1.35x |
Der B300-Vergleich ist absichtlich qualifiziert: öffentliches Humming hat keine SM100/SM103-Tuning-Tabelle, daher ist seine Standardzeit eine untune-Referenz. H200-indizierte Verhältnisse sind der tuned-to-tuned-Vergleich.
Beide Familien werden gegen dieselbe öffentliche Humming-Revision gemessen, 4351af3. Gruppierte Zeilen vergleichen mit den eigenen grouped_contiguous/grouped_masked-Pfaden von Humming, nicht mit dessen indiziertem, da dies der Vertrag ist, den dieses Backend ersetzt. Humming stellt beide als GemmType-Werte bereit, die über seinen generischen Kernel verteilt werden, nicht als separate CUDA-Dateien, und benchmarks/bench_humming.py wählt sie mit --gemm_type grouped_contiguous oder --gemm_type grouped_masked aus. Die Zeilen pro Expert werden auf beiden Seiten bei Vielfachen der 128-Zeilengrenze abgestimmt – --balanced auf der Humming-Seite und die ausgerichteten Fälle in tests/test_w4a16_grouped.py – sodass jede Zeile für beide Implementierungen dieselbe GEMM-Form ist und kein Tile für Padding verbraucht wird.
End-to-End-Serving
Ein früherer Servig-Bericht maß den indizierten TP8-Pfad auf Kimi-K2.6 mit 8×H200, TP8 + DP8, FP8-KV-Cache und ShareGPT-Anfragen. Beide Anbieter verwendeten den selben --quantiization humming- Befehl.
| Metrik | Humming | Chord | Änderung |
|---|---|---|---|
| Mittlere TTFT | 2022 ms | 1849 ms | −8.6% |
| Prefill-Eingabe + Ausgabe-Durchsatz | 20.716 tok/s | 22.712 tok/s | +9.6% |
| Decode-Ausgabe-Durchsatz, Batch 8 | 483 tok/s | 503 tok/s | +4.1% |
| Decode-Ausgabe-Durchsatz, Batch 64 | 1.650 tok/s | 1.740 tok/s | +5.5% |
| Decode-Ausgabe-Durchsatz, Batch 128 | 2.514 tok/s | 2.715 tok/s | +8.0% |
Prefill verwendete ein A usgabe-Token mit deaktiviertem Prefix-Caching. Decode verwendete die selben Prompts in einem zweiten Durchlauf mit einem vollständig warmen Prefix-Cache. Der Bericht fand auch keine Genauigkeitsregression gegenüber Humming auf OCRBench und GSM8K.
Was als Nächstes kommt
- Vollständige Integration der gruppierten Operatoren mit dem Humming-Backend von vLLM, sodass die kontinuierlichen und maskierten Operatoren über die bestehende Framework-Integration verfügbar werden.
- Veröffentlichung von EP8-Prefill-Kernels für B200/B300. Wir haben eine funktionierende Implementierung mit vielversprechender Leistung in internen Tests und planen, die Kernels und Benchmarks in einem Folge-Release zu teilen.
Probieren Sie Chord aus
Chord ist auf GitHub verfügbar: novitalabs/chord. Die Dokumentation deckt Erste Schritte, Optimierungen, Leistung, Tuning-Interna und Benchmark-Methodik ab. Feedback, Issues und Benchmark-Berichte aus anderen Deployments sind sehr willkommen.
Häufig gestellte Fragen
Was ist Chord in vLLM?
Chord ist ein W4A16 INT4 Mixture-of-Experts CUDA-Kernelpaket von Novita AI. Sein indizierter Pfad bietet ein Humming-kompatibles Import-Root für vLLM-Revisionen, die das erforderliche WNA16-Group-Scale-Format unterstützen.
Welche GPUs und Modelle zielt Chord ab?
Die veröffentlichten Profile zielen auf Kimi-K2.x-Serving-Shapes auf NVIDIA H200- und Blackwell-GPUs ab, einschließlich H200 EP8/TP8- und B300 EP8-Decode-Szenarien. Die gruppierte SM90-Familie zielt derzeit auf Hopper-Klasse-GPUs ab.
Ist Chord in vLLM integriert?
Der indizierte Pfad kann das bestehende Humming-Backend von vLLM mit --quantization humming oder moe_backend="humming" verwenden. Gruppierte kontinuierliche und maskierte Operatoren werden derzeit über die eigenständige Chord-API bereitgestellt; die Integration der gruppierten Operatoren in vLLM ist noch in Arbeit.
Wo finde ich Chord-Benchmarks und Einrichtungsanleitungen?
Verwenden Sie das Chord-Repository, insbesondere dessen Dokumentation zu Erste Schritte, Leistung und Benchmarks.
Danksagungen
Der indizierte Pfad von Chord baut auf inclusionAI/Humming auf, während das gruppierte SM90-Backend die DeepGEMM-Hopper-GEMM-Infrastruktur für W4A16 spezialisiert. Chord wird unter Apache-2.0 veröffentlicht. Die Quellhinweise des Repositorys dokumentieren die beibehaltenen Upstream-Komponenten und Hinweise.
Wir danken dem Novita AI-Team für die Entwicklung und Veröffentlichung von Chord als Open Source sowie den vLLM-Maintainern und der breiteren vLLM-Community für die Diskussionen, Reviews und die Quantisierungs- und MoE-Backend-Infrastruktur, die diese Integration ermöglicht haben.